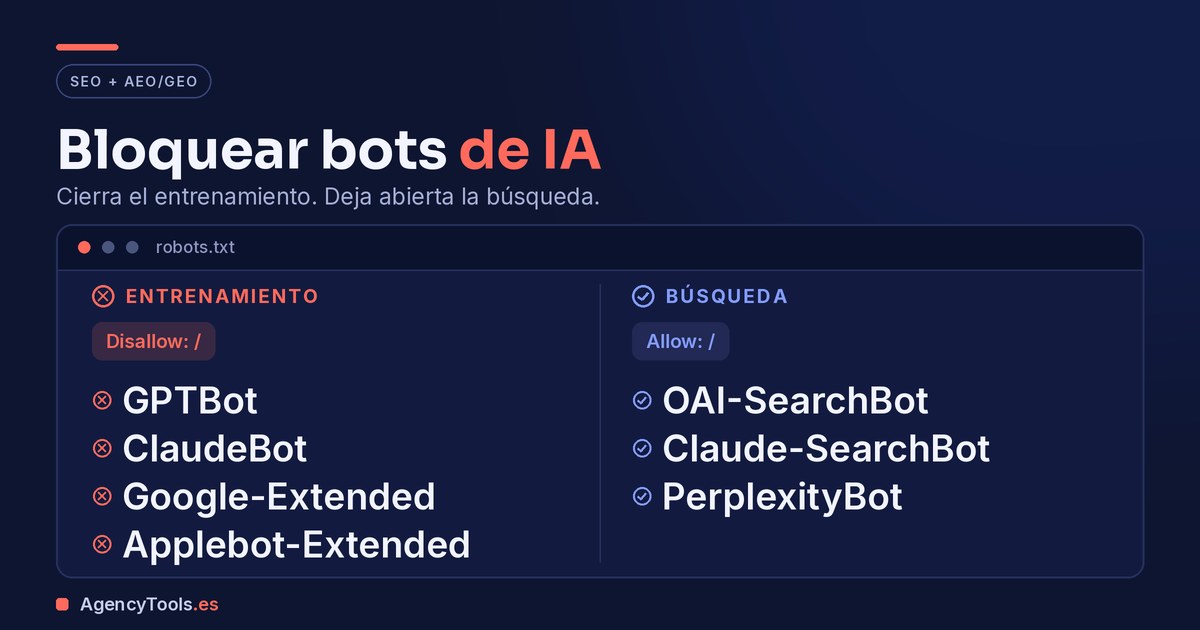
Bloquear bots de IA con un Disallow: / genérico es la respuesta rápida a una pregunta que casi nunca es la que el cliente está haciendo. La mayoría de las veces lo que quiere decir es «no quiero que entrenen un modelo con mi contenido sin pagarme», y eso es una decisión distinta de «no quiero aparecer cuando alguien pregunte por mi sector en ChatGPT». Son dos palancas separadas, con agentes separados, y confundirlas cuesta visibilidad sin aportar ninguna protección real.
Esta guía es para agencias, freelances y equipos in-house en España que administran el robots.txt de webs de clientes y necesitan una postura defendible: qué hace cada rastreador, qué se pierde exactamente al cerrarlo y qué dejar escrito en el archivo.
En resumen (puntos clave)
- Entrenamiento y respuesta son dos cosas distintas. Casi todas las empresas de IA usan un agente para entrenar sus modelos y otro para buscar y citar. Se pueden separar.
- Google-Extended es la regla más barata de todas. Google documenta que no afecta a la inclusión en la Búsqueda ni se usa como señal de posicionamiento.
- No existe un botón para salir de las AI Overviews. Se sirven del rastreo de Googlebot: el único bloqueo que te saca de ahí es el que te saca de Google.
- Bloquear GPTBot no te saca de ChatGPT. El que te saca de las respuestas de búsqueda de ChatGPT es bloquear OAI-SearchBot.
- El robots.txt declara preferencias, no impide accesos. Los agentes que actúan a petición de un usuario pueden saltárselo, y algunos lo documentan explícitamente.
- Un bot con grupo propio no lee el grupo
*. De ahí salen los dos fallos que más se repiten: una reserva de derechos que solo aplica a un bot, y rutas privadas que se abren sin querer al crear un grupo nuevo. - En España hay una base legal para la reserva de derechos: el artículo 67 del Real Decreto-ley 24/2021, que es el que da sentido a declararlo por escrito en el propio archivo, lo obedezca alguien o no.
Antes de bloquear bots de IA: quién es quién en 2026
Este es el cuadro que conviene tener delante antes de tocar nada. La columna que importa no es lo que hace el bot, es qué pierde el cliente si lo cierras.
| Agente en robots.txt | Empresa | Para qué se usa | Qué pierdes al bloquearlo |
|---|---|---|---|
GPTBot | OpenAI | Entrenar modelos generativos | Nada de visibilidad |
OAI-SearchBot | OpenAI | Función de búsqueda de ChatGPT | Dejas de aparecer en las respuestas de búsqueda de ChatGPT |
ChatGPT-User | OpenAI | Visitas lanzadas por un usuario | Poco: no es rastreo automático y pueden no aplicarse las reglas |
Google-Extended | Entrenar y fundamentar modelos Gemini | Nada en la Búsqueda de Google | |
Googlebot | Búsqueda, y con ella las funciones de IA | Todo. Sales de Google | |
ClaudeBot | Anthropic | Entrenar y desarrollar modelos | Nada de visibilidad |
Claude-SearchBot | Anthropic | Indexar para mejorar resultados | Menos visibilidad en las búsquedas de Claude |
Claude-User | Anthropic | Recuperar una web a petición del usuario | Que Claude no pueda abrir tu página cuando se la piden |
PerplexityBot | Perplexity | Mostrar y enlazar webs en sus resultados | Visibilidad en Perplexity |
Perplexity-User | Perplexity | Visitas lanzadas por un usuario | Poco: Perplexity documenta que generalmente ignora el robots.txt |
Applebot-Extended | Apple | Entrenar modelos generativos de Apple | Nada: las páginas siguen pudiendo salir en resultados |
Fíjate en el patrón. En OpenAI, Anthropic y Apple la pareja es la misma: un agente de entrenamiento que puedes cerrar sin coste de visibilidad y un agente de búsqueda que sí te cuesta cerrar. Google lo resuelve distinto, y es donde se concentran los malentendidos.
El error que más veces nos encontramos: Google-Extended
La escena típica es un cliente preocupado por las AI Overviews que pide «que Google no use nuestro contenido para la IA». Alguien añade User-agent: Google-Extended con Disallow: /, todos quedan tranquilos y no cambia absolutamente nada en las AI Overviews.
Google-Extended sirve para que un editor decida si el contenido que Google ya ha rastreado puede usarse para entrenar futuras generaciones de modelos Gemini y para fundamentar respuestas en las aplicaciones de Gemini. La documentación de Google añade la parte que casi nadie lee: Google-Extended no afecta a la inclusión de un sitio en la Búsqueda de Google ni se usa como señal de posicionamiento.
O sea, es una regla sin coste. Puedes ponerla en casi cualquier cliente y no perder nada. Lo que no hace es sacarte de las AI Overviews.
¿Se puede salir de las AI Overviews sin salir de Google?
No con un interruptor propio. Google documenta que las directivas de robots.txt para Googlebot son el control con el que un propietario gestiona cómo se rastrea su sitio para la Búsqueda, y que las funciones de IA (AI Overviews y el Modo IA) forman parte de esa Búsqueda. El mismo documento remata la idea desde el otro lado: no hay requisitos adicionales para aparecer en las AI Overviews o el Modo IA, ni optimizaciones especiales necesarias.
Lo que sí tienes es el control del fragmento. Las etiquetas nosnippet, data-nosnippet y max-snippet limitan qué información puede mostrar Google de tus páginas, y ese límite se aplica también a las funciones de IA. Es útil en casos concretos —una ficha de producto con precio, un contenido de pago, un dato que no quieres que se lea sin entrar—, pero recorta igualmente el fragmento en los resultados clásicos. Antes de aplicarlo en toda la web, aplícalo con data-nosnippet en el bloque concreto que quieres proteger.
Si lo que el cliente busca es lo contrario, salir más en esas respuestas en vez de menos, el camino es el de siempre: estructura, entidades claras y pasajes citables, apoyados en datos estructurados bien implantados.
Separa las dos decisiones antes de escribir una línea
Estas son las dos preguntas que hay que hacerle al cliente, por separado y en este orden:
- ¿Quieres que tu contenido entrene modelos de IA? Si la respuesta es no, se cierran
GPTBot,ClaudeBot,Google-ExtendedyApplebot-Extended. Coste en visibilidad: ninguno. - ¿Quieres aparecer cuando alguien pregunte por tu sector a un asistente? Si la respuesta es sí, y para un negocio comercial casi siempre lo es, se dejan abiertos
OAI-SearchBot,Claude-SearchBotyPerplexityBot.
De ahí sale la postura por defecto que nosotros aplicamos salvo que haya un motivo concreto para desviarse: cerrado a entrenamiento, abierto a respuesta. Es la que deja al cliente con la visibilidad que le puede traer tráfico y con sus derechos reservados sobre el uso que no le devuelve nada.
Cuándo conviene desviarse
- Medio de comunicación, editorial o base de datos propietaria. Aquí el contenido es el producto. Tiene sentido cerrar también los agentes de búsqueda y negociar el acceso, o valorar un esquema de cobro (más abajo).
- Web de servicios locales, SaaS, e-commerce, agencia. Cerrar los agentes de búsqueda es tirar piedras al propio tejado: son un canal de descubrimiento, no un competidor.
- Intranet, portal de cliente, entorno de pruebas. No es un problema de IA. Eso va detrás de autenticación, no de robots.txt.
- Web con contenido de terceros o bajo licencia. Revisa el contrato antes de decidir por el cliente: puede que la reserva de derechos no sea suya.
¿Qué robots.txt dejo montado?
Este es el bloque que aplicamos en una web comercial estándar. No toca a Googlebot y respeta la regla que explico justo debajo: la reserva de derechos va arriba, en el grupo general, no suelta al final del archivo.
# --- Reserva de derechos (art. 67.3 RDL 24/2021) ---
# NO pegues este grupo: tu cliente YA tiene un User-agent: *.
# Añade únicamente la línea Content-Signal al grupo que ya existe.
User-agent: *                      # <-- el que ya tienes, no lo dupliques
Content-Signal: search=yes, ai-input=yes, ai-train=no   # <-- añade solo esta línea
Allow: /

# --- Entrenamiento de modelos: no ---
User-agent: GPTBot
Content-Signal: ai-train=no
Disallow: /

User-agent: ClaudeBot
Content-Signal: ai-train=no
Disallow: /

User-agent: Google-Extended
Content-Signal: ai-train=no
Disallow: /

User-agent: Applebot-Extended
Content-Signal: ai-train=no
Disallow: /

# --- Búsqueda y citación: sí ---
# OJO: repite DENTRO de cada grupo los Disallow que tenga tu grupo *.
# Los de ejemplo son los típicos; pon los del cliente.
User-agent: OAI-SearchBot
Disallow: /carrito/
Disallow: /checkout/
Allow: /

User-agent: Claude-SearchBot
Disallow: /carrito/
Disallow: /checkout/
Allow: /

User-agent: PerplexityBot
Disallow: /carrito/
Disallow: /checkout/
Allow: /
Por qué el orden importa: un bot solo lee su grupo
Esto es lo que más veces se hace mal, y no es un detalle de estilo. Content-Signal es una directiva de grupo: vive bajo una línea User-agent, al lado de Allow y Disallow. El ejemplo canónico de Cloudflare es exactamente ese orden, User-Agent: * seguido de Content-Signal y de Allow: /. Un comentario # no abre un grupo nuevo ni cierra el anterior.
Si dejas la línea de reserva al final del archivo, justo detrás de User-agent: PerplexityBot, no estás declarando nada global: estás declarando las preferencias de PerplexityBot y de nadie más. Que es, con ironía, el único bot al que este bloque deja abierto a propósito.
Y hay una segunda consecuencia, la que de verdad conviene interiorizar. La especificación de robots.txt de Google lo dice sin ambigüedad: los grupos específicos de un user agent y los grupos globales (*) no se combinan, y sus rastreadores buscan el grupo con el user agent más específico que coincida, de modo que los demás grupos se ignoran. En la práctica:
- Un bot con grupo propio no lee el grupo
*. Si quieres que la reserva conste también frente a GPTBot o ClaudeBot en particular, la líneaContent-Signalhay que repetirla dentro de cada grupo. Por eso aparece duplicada en el bloque de arriba. - Y al revés, que es el efecto colateral caro: en el momento en que creas un grupo para
OAI-SearchBot, ese bot deja de aplicar losDisallowdel grupo*del cliente. Si el archivo tenía unDisallow: /checkout/o/carrito/ahí arriba, al pegar este bloque esas rutas quedan abiertas a los tres agentes de búsqueda. Es el tipo de fallo que se descubre tres meses después, en un informe de cobertura.
Cuatro avisos prácticos antes de copiar nada:
- Repite los
Disallowdel grupo*dentro de cada grupo nuevo. Es la línea comentada del bloque, y no es opcional: sin ella estás abriendo rutas que el cliente había cerrado. - Un robots.txt por host. Anthropic recuerda que las directivas hay que aplicarlas en cada subdominio. Si el blog del cliente vive en
blog.dominio.es, ese archivo también se toca. - No bloquees por IP. La propia documentación de Anthropic advierte de que bloquear por dirección IP puede impedir que el bot lea tu robots.txt, con lo que el bloqueo que querías declarar nunca llega a leerse. Para verificar el origen existe una lista publicada de IPs.
- Revísalo cada trimestre. Los agentes se renombran, se dividen y aparecen nuevos. Un robots.txt escrito en 2024 hoy ya no cubre la mitad del mapa.
Content-Signal: decir por escrito lo que el robots.txt no dice
La última línea del bloque anterior no es decorativa. Cloudflare publicó el 24 de septiembre de 2025 la Content Signals Policy, una extensión del robots.txt que separa tres usos: search (indexar y devolver enlaces y extractos), ai-input (usar el contenido en tiempo real para fundamentar una respuesta generativa) y ai-train (entrenar o afinar modelos). Se declaran con sí o no, y omitir uno significa que no expresas preferencia.
Lo relevante para España no es la sintaxis, es lo que la acompaña: la política declara que cualquier restricción expresada por esta vía constituye una reserva expresa de derechos al amparo del artículo 4 de la Directiva (UE) 2019/790. En nuestro ordenamiento, esa directiva se transpuso mediante el Real Decreto-ley 24/2021, cuyo artículo 67 regula el límite de minería de textos y datos y, en su apartado 3, lo deja sin efecto cuando el titular ha reservado expresamente ese uso por medios de lectura mecánica u otros medios adecuados. El robots.txt es, precisamente, un medio de lectura mecánica.
Pasemos a Content-Signal la misma prueba que a llms.txt
Sería deshonesto recomendar esta línea sin aplicarle el examen que más abajo le aplico a llms.txt, así que aquí va. No consta que ningún rastreador actúe sobre ella. El 6 de julio de 2026, John Mueller dijo de la directiva de Cloudflare que «no tiene efecto alguno para ningún rastreador ni ningún LLM» y que ponerla «solo añade peso y mantenimiento futuro a tu archivo robots.txt». La propia Cloudflare lo admite desde el otro lado: las señales expresan preferencias y no son contramedidas técnicas frente al scraping, y habrá quien las ignore. Y la especificación de robots.txt de Google solo reconoce cuatro campos —user-agent, allow, disallow y sitemap—; el resto de líneas las ignora su analizador.
Entonces, ¿por qué la mantengo en el bloque? Porque su valor no es conductual, es probatorio, y son dos cosas distintas que conviene no mezclar. Una reserva de derechos al amparo del artículo 4 de la Directiva 2019/790 y del artículo 67.3 del RDL 24/2021 no necesita que ningún rastreador la obedezca para existir: necesita estar hecha, por escrito, en un medio de lectura mecánica y con fecha. Esa es exactamente la función que cumple. Cuesta una línea y no depende de que nadie la respete.
Lo que el robots.txt no puede hacer
Aquí es donde la conversación se vuelve honesta. El robots.txt es una convención voluntaria, no un control de acceso: un scraper que no quiera respetarla, no la respeta. De ahí salen tres límites que conviene decirle al cliente antes de que los descubra por su cuenta.
- Los agentes a petición del usuario juegan con otras reglas. OpenAI indica que ChatGPT-User no rastrea la web de forma automática y que las reglas del robots.txt pueden no aplicársele. Perplexity documenta directamente que Perplexity-User generalmente las ignora, por tratarse de una acción iniciada por una persona.
- No es una medida de protección de datos. Si en la web hay datos personales que no deberían estar publicados, el problema es de RGPD y LOPDGDD y se resuelve quitándolos o poniéndolos detrás de autenticación, no con un
Disallow. - No es marcha atrás. Bloquear hoy no retira lo que ya se rastreó ayer.
Si el cliente necesita control real y no una declaración, la conversación cambia de sitio: autenticación, muro de pago, limitación de velocidad o un WAF. Ahí es donde ha ido el mercado desde que Cloudflare empezó, el 1 de julio de 2025, a bloquear por defecto a los rastreadores de IA que no compensen al creador, con esquemas de cobro por rastreo para el caso del editor, hoy en beta cerrada, en los que el sitio responde con un HTTP 402 Payment Required antes de entregar nada.
Un apunte práctico aunque no uses nada de esto: si el robots.txt del cliente lo gestiona el CDN y no está en el repositorio, puede que ya haya una política escrita que nadie ha leído. Los paneles de gestión de bots escriben en ese archivo por su cuenta y con su propia sintaxis. Antes de escribir, mira qué hay.
¿Y llms.txt?
Aparece en todas las propuestas de «optimización para IA» del último año, así que conviene zanjarlo. llms.txt es un archivo propuesto para dar a los modelos una versión ordenada del contenido de un sitio. La postura de Google es que no lo utiliza: John Mueller ha señalado que ningún servicio de IA ha confirmado usarlo y que en los registros de servidor no se aprecia que lo consulten, y desde el equipo de Búsqueda se ha descrito como especulativo por ahora.
Traducción para una propuesta a cliente: puedes montarlo, no rompe nada y tiene un caso de uso real en documentación técnica que consumen asistentes de código. Lo que no puedes es venderlo como palanca de visibilidad ni cobrarlo como tal. El robots.txt sí está en el presupuesto; el llms.txt, por ahora, es un extra.
Y para cerrar el círculo con la sección anterior, porque la simetría importa: llms.txt y Content-Signal suspenden el mismo examen. Hoy no consta que ningún rastreador actúe sobre ninguno de los dos, y es el propio Mueller quien lo ha dicho de ambos. La diferencia no está en la evidencia de uso, está en para qué sirve cada uno. Content-Signal no aspira a cambiar el comportamiento de un bot: documenta una reserva de derechos que existe aunque nadie la lea. llms.txt sí aspira a cambiarlo, y ahí es donde no hay nada que enseñar. Por eso uno se queda en el archivo por una línea y el otro no se factura.
Checklist: dejar resuelto el robots.txt de un cliente
- Inventaría los hosts: dominio principal, subdominios, blog, tienda, landings en dominios aparte.
- Confirma que Googlebot no está bloqueado por error. Es el fallo que más caro sale y no tiene nada que ver con la IA.
- Pregunta al cliente las dos preguntas separadas: entrenamiento y respuesta.
- Apunta los
Disallowque ya tenga el grupo*antes de tocar nada:/carrito/,/checkout/,/wp-admin/, buscadores internos. Los vas a necesitar en el paso 6. - Aplica el bloque de agentes en cada host, no solo en el principal.
- Repite esos
Disallowdentro de cada grupo nuevo que crees. Un bot con grupo propio ignora el grupo*: si no los copias, le acabas de abrir rutas que estaban cerradas. - Añade la línea
Content-Signalcon la decisión tomada al grupo*que el cliente ya tiene (no crees uno nuevo debajo) y repítela en los grupos donde quieras que la reserva conste de forma específica. - Comprueba el archivo publicado en
dominio.es/robots.txty valídalo en el informe de robots.txt de Search Console. - Si hay contenido sensible que se escapa, resuélvelo con
data-nosnippeten el bloque concreto o con autenticación, no cerrando la web entera. - Documenta la decisión en el acta del cliente, con fecha. Dentro de seis meses alguien preguntará por qué está eso ahí.
- Marca una revisión trimestral en el calendario.
Lo que conviene recordar
La pregunta «¿bloqueamos la IA?» no tiene una respuesta única porque no es una sola pregunta. Separarla en dos, entrenar y responder, convierte una discusión ideológica en dos decisiones de negocio que un cliente puede tomar en cinco minutos, y te deja a ti con un archivo defendible en lugar de un Disallow heredado que nadie sabe justificar.
Y baja las expectativas en el sitio correcto, que es el que sostiene todo lo anterior: el robots.txt reserva derechos, no impide accesos. Señal de comportamiento y reserva jurídica son dos cosas distintas, y casi todo el ruido de este tema viene de tratarlas como si fueran una. La reserva vale aunque nadie la obedezca, porque su función es constar. El bloqueo real, si el cliente lo necesita, se compra en otra tienda: autenticación, muro de pago o WAF.
Esa distinción es también la prueba del algodón para cualquier propuesta que te llegue. Si alguien te vende un archivo prometiendo que cambiará el comportamiento de los modelos, pídele la evidencia. A día de hoy, para llms.txt y para Content-Signal, no la hay. Uno se pone igual porque documenta un derecho; el otro, por ahora, no se factura.
Con el archivo resuelto, lo siguiente es medir: cómo aislar el tráfico que llega desde asistentes de IA en GA4 y Search Console, para que la decisión se pueda revisar con datos. Y si la web del cliente además no termina de entrar en el índice, el problema suele ser anterior y está en las causas habituales de que Google no indexe.
¿No sabes en qué estado está el robots.txt de la cartera? Preparamos auditorías de SEO, redes sociales y campañas en blanco (white label) que puedes entregar con tu marca e incluyen la revisión de rastreo, indexación y visibilidad en buscadores de IA; son compatibles con proyectos de Kit Digital si trabajas como agente digitalizador. Solicita una auditoría de prueba y úsala para abrir la conversación con el cliente.
Preguntas frecuentes
¿Bloquear GPTBot me saca de ChatGPT?
No. OpenAI usa agentes distintos para cosas distintas: GPTBot rastrea contenido para entrenar sus modelos, OAI-SearchBot alimenta la función de búsqueda de ChatGPT y ChatGPT-User atiende las peticiones que lanza un usuario. La documentación de OpenAI es explícita: cada ajuste es independiente de los demás, y pone como ejemplo permitir OAI-SearchBot para aparecer en los resultados mientras se bloquea GPTBot. Quien queda fuera de las respuestas de búsqueda de ChatGPT es el que bloquea OAI-SearchBot, y aun así el sitio puede seguir apareciendo como enlace de navegación.
¿Si bloqueo Google-Extended pierdo posiciones en Google?
No. Google-Extended solo controla si el contenido que Google ya ha rastreado puede usarse para entrenar y fundamentar modelos Gemini. La documentación de Google lo dice sin matices: Google-Extended no afecta a la inclusión de un sitio en la Búsqueda de Google ni se usa como señal de posicionamiento. Es probablemente la regla con mejor relación entre lo que tranquiliza al cliente y lo que cuesta en visibilidad: cero.
¿Cómo se sale de las AI Overviews sin salir de Google?
No hay un interruptor específico. Las funciones de IA de la Búsqueda se sirven del rastreo de Googlebot, así que el único bloqueo que te saca de las AI Overviews es el que también te saca de la Búsqueda. Lo que sí existe es limitar qué se puede mostrar: las etiquetas nosnippet, data-nosnippet y max-snippet reducen o eliminan el fragmento que Google puede extraer, y eso afecta igualmente a las funciones de IA. El coste es que también recortas tu fragmento en los resultados clásicos.
¿Sirve de algo el archivo llms.txt?
Hoy no hay evidencia de que sirva para visibilidad en buscadores. John Mueller, de Google, ha señalado que ningún servicio de IA ha confirmado que lo utilice y que en los registros de servidor no se aprecia que lo consulten, y desde Google se ha descrito como especulativo por ahora. Montarlo no rompe nada y tiene sentido en documentación técnica que consumen asistentes de código, pero no es una palanca de posicionamiento ni sustituye a un robots.txt bien puesto.
¿Sirve de algo la línea Content-Signal si ningún rastreador la obedece?
Sirve como prueba, no como control. El 6 de julio de 2026 John Mueller, de Google, dijo de la directiva de Cloudflare que no tiene efecto alguno para ningún rastreador ni ningún LLM y que solo añade peso al archivo; la especificación de robots.txt de Google, de hecho, solo reconoce cuatro campos (user-agent, allow, disallow y sitemap) e ignora el resto. Aun así merece la línea: la reserva de derechos al amparo del artículo 4 de la Directiva (UE) 2019/790 y del artículo 67.3 del RDL 24/2021 no necesita que un bot la obedezca para existir, necesita estar hecha por escrito en un medio de lectura mecánica.
¿Dónde se pone exactamente la línea Content-Signal en el robots.txt?
Dentro de un grupo, bajo una línea User-agent y al lado de Allow y Disallow, nunca suelta al final del archivo. El ejemplo de Cloudflare es User-Agent: * seguido de Content-Signal y de Allow: /. Esto importa porque la especificación de Google establece que los grupos específicos y el grupo global no se combinan y que un rastreador solo aplica el grupo más específico que coincida, ignorando los demás. Si dejas la línea al final, detrás del último User-agent, estarás declarando las preferencias de ese bot y de ningún otro. Para que la reserva conste frente a GPTBot o ClaudeBot en concreto, hay que repetirla dentro de su grupo.
¿Qué pongo en el robots.txt de un cliente si no tengo una decisión clara?
El punto de partida razonable para la mayoría de webs comerciales en España es cerrar el entrenamiento y dejar abierta la respuesta: bloquear GPTBot, ClaudeBot, Google-Extended y Applebot-Extended, y permitir OAI-SearchBot, Claude-SearchBot y PerplexityBot. El cliente conserva la visibilidad en las respuestas de IA, que es de donde puede llegarle tráfico, y reserva el uso de su contenido para entrenar modelos. Documenta la decisión y revísala cada trimestre, porque los agentes cambian de nombre y de función con frecuencia.
Fuentes
- Google Search Central — Rastreadores comunes de Google: descripción de
Google-Extendedy afirmación expresa de que no afecta a la inclusión de un sitio en la Búsqueda de Google ni se usa como señal de posicionamiento. - Google Search Central — Funciones de IA en la Búsqueda de Google: las directivas de robots.txt para Googlebot son el control de rastreo para la Búsqueda;
nosnippet,data-nosnippetymax-snippetlimitan lo que se muestra; «no hay requisitos adicionales para aparecer en las AI Overviews o el Modo IA». - OpenAI — Overview of OpenAI Crawlers: funciones de
GPTBot,OAI-SearchBotyChatGPT-User; «Each setting is independent of the others»; efecto de bloquearOAI-SearchBot. - Anthropic — Does Anthropic crawl data from the web, and how can site owners block the crawler?: funciones de
ClaudeBot,Claude-UseryClaude-SearchBot; aplicación por subdominio; advertencia sobre el bloqueo por IP. - Perplexity — PerplexityBot y Perplexity-User:
PerplexityBotno se usa para entrenar modelos;Perplexity-User«generally ignores robots.txt rules». - Apple — About Applebot:
Applebot-Extendedcomo exclusión voluntaria del entrenamiento; «Webpages that disallow Applebot-Extended can still be included in search results». - Google Search Central — Especificaciones de robots.txt: campos admitidos (
user-agent,allow,disallow,sitemap) y resto de líneas ignoradas por el analizador; «User agent specific groups and global groups (*) are not combined» y selección del grupo más específico, con los demás grupos ignorados. - Cloudflare — Introducing the Content Signals Policy (24 de septiembre de 2025): señales
search,ai-inputyai-train; ejemplo canónicoUser-Agent: */Content-Signal:/Allow: /; reserva expresa de derechos al amparo del artículo 4 de la Directiva (UE) 2019/790; «content signals express preferences; they are not technical countermeasures against scraping». - Cloudflare — Content Independence Day (1 de julio de 2025) y documentación de pay per crawl: cambio de la configuración por defecto y esquema de cobro con respuesta
HTTP 402 Payment Required, en beta cerrada. - Search Engine Roundtable — Google Says Cloudflare Content Signals Robots.txt Directive Has No Effects Whatsoever (6 de julio de 2026): declaración de John Mueller, «it has no effects whatsoever for any crawler or llm. Using it just adds bloat & future maintenance to your robots.txt file».
- BOE — Real Decreto-ley 24/2021, de 2 de noviembre: artículo 67, límite de minería de textos y datos y reserva expresa de derechos por medios de lectura mecánica (apartado 3).
- Search Engine Journal — Google Says LLMs.txt Is “Purely Speculative” For Now y Search Engine Roundtable — Google Search Team Does Not Endorse LLMs.txt Files: declaraciones de John Mueller sobre el uso real del archivo.