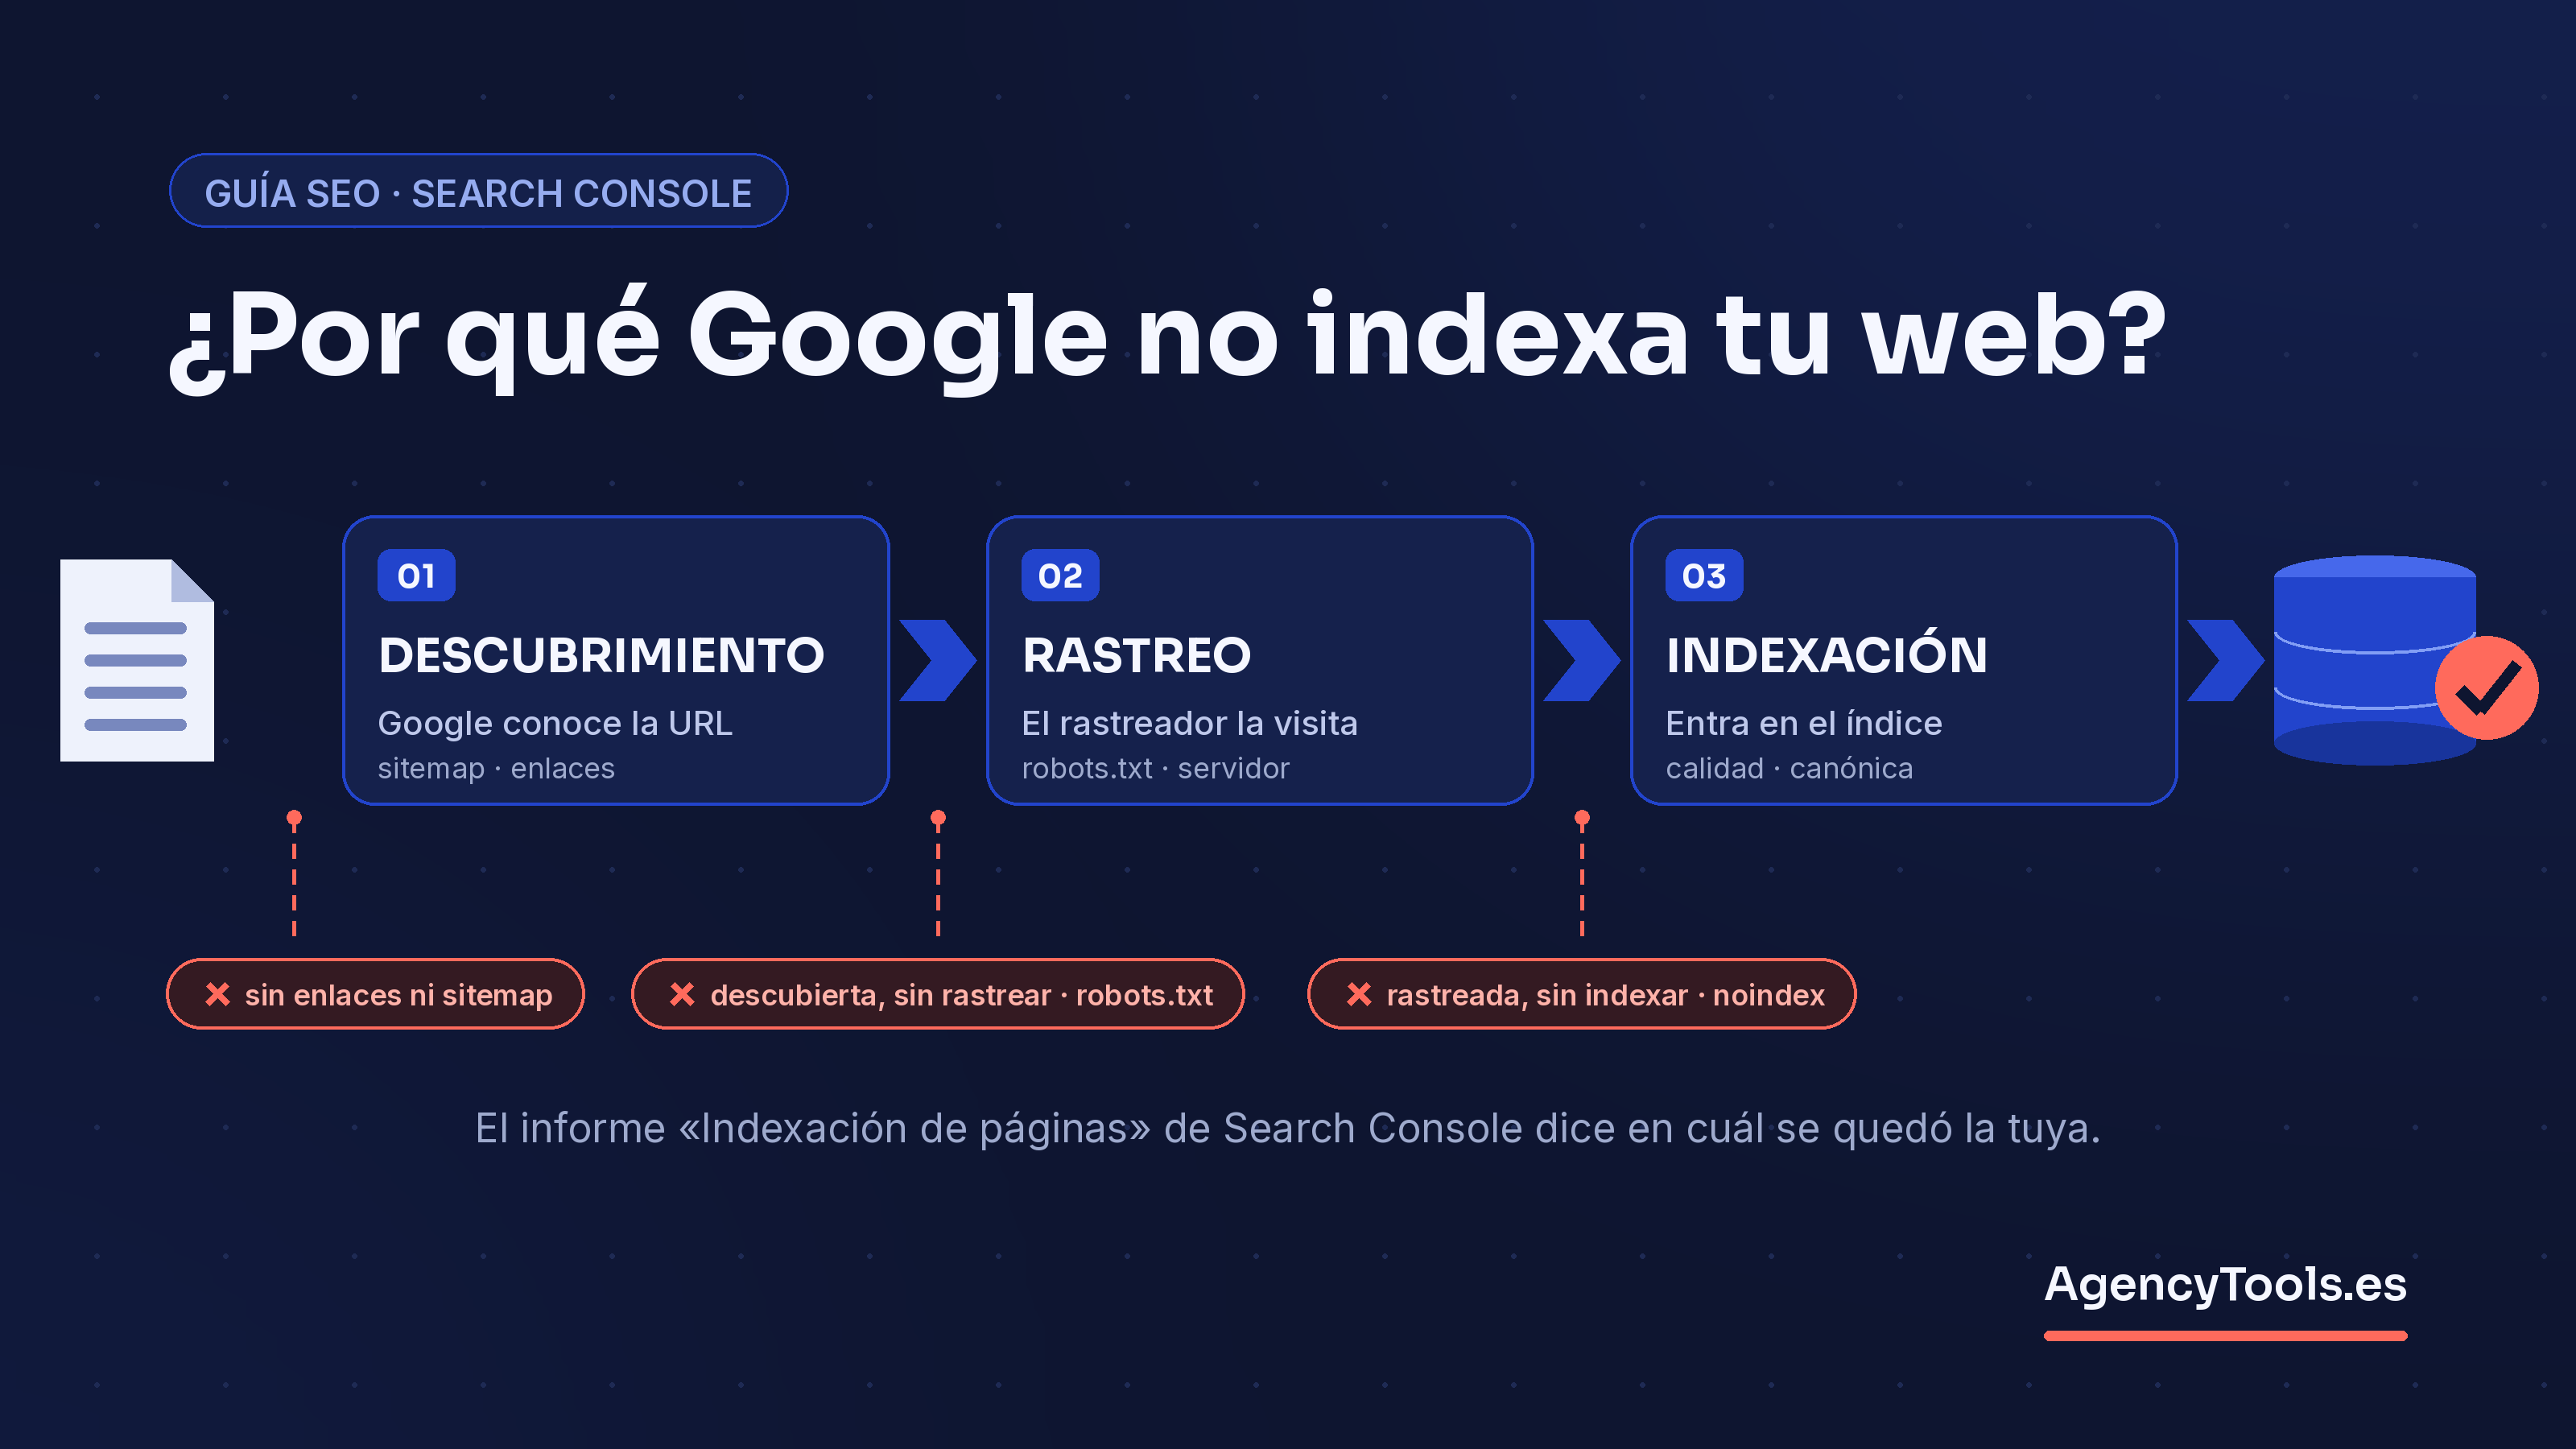
Google no indexa tu web por una de estas cuatro razones: se lo has impedido sin darte cuenta (noindex, robots.txt, canónica mal puesta), la ha rastreado y no le ha parecido lo bastante útil, la ha agrupado con otra página casi idéntica y ha elegido esa otra, o simplemente todavía no le ha llegado el turno. El informe «Indexación de páginas» de Search Console te dice cuál de las cuatro es tu caso. Todo lo demás —volver a enviar el sitemap, pedir indexación tres veces, tocar el robots.txt por si acaso— es ruido hasta que sepas eso.
Es una de las llamadas más incómodas que recibe una agencia. El cliente entra en Google, busca su propia página de servicios, no la encuentra y pregunta si el trabajo está hecho. La respuesta honesta rara vez es «hay que esperar» y casi nunca es «hay que meter más palabras clave». Es un diagnóstico, y se hace en un orden concreto.
En resumen (puntos clave)
- Indexar no está garantizado. Google no promete indexar todas las páginas de un sitio. Es una decisión suya, y el margen de maniobra está en darle razones, no en insistir.
- Empieza por el estado, no por la solución. Cada estado del informe de indexación apunta a una causa distinta y a un arreglo distinto. Diagnosticar mal cuesta semanas.
- «Descubierta: actualmente sin indexar» es una cola; «Rastreada: actualmente sin indexar» es un juicio. El primero se resuelve con enlazado y paciencia; el segundo, reescribiendo o fusionando contenido.
- El error más caro es combinar
noindexcon un bloqueo enrobots.txt. Si Google no puede acceder a la página, no ve la etiqueta, y la URL puede seguir apareciendo. - Si la página no está indexada, no puede citarse en las respuestas de IA. Google exige que la página esté indexada para figurar como enlace de contribución en las Vistas creadas con IA y en el Modo IA. La indexación es el suelo sobre el que se construye el AEO.
¿Qué significa exactamente que una página no esté indexada?
Que no está en el índice de Google, y por tanto no puede aparecer en ningún resultado. Conviene separar las tres fases, porque el vocabulario se mezcla mucho en las reuniones:
- Descubrimiento: Google se enteró de que la URL existe (por un sitemap, por un enlace interno o externo).
- Rastreo: el robot ha entrado y ha descargado el contenido.
- Indexación: Google ha analizado la página y ha decidido guardarla en el índice.
Una página puede quedarse en cualquiera de los tres escalones, y el motivo es diferente en cada uno. Por eso la pregunta útil no es «¿por qué no aparece?» sino «¿en qué escalón se ha quedado?».
Primer paso: abre el informe correcto
En Search Console, ve a Indexación > Páginas. Ese informe divide tus URLs en indexadas y no indexadas, y agrupa las segundas por motivo. Ahí está el diagnóstico. Para una URL concreta, usa la Inspección de URLs (la barra de búsqueda de arriba): te dice si está indexada, cuál es la canónica que Google ha elegido y si hay algo que se lo impida.
Dos avisos antes de seguir:
- No mires solo el total. Un sitio con 400 páginas no indexadas puede estar perfectamente sano si son etiquetas, paginaciones y filtros que no quieres en el índice. Lo que importa es si están fuera las páginas que sí quieres dentro.
- Comprueba la propiedad. Si tienes la propiedad configurada por prefijo de URL (
https://www.dominio.es/) y el sitio resuelve sinwww, estarás leyendo un informe casi vacío. La propiedad de tipo dominio evita ese despiste.
Por qué Google no indexa mi web, estado por estado
Esta es la tabla que conviene tener delante. Los nombres son los que usa Search Console en español; los cito tal cual para que puedas buscarlos en el informe sin traducir.
| Estado en Search Console | Qué está pasando de verdad | Qué hacer |
|---|---|---|
| La URL se ha marcado como «noindex» | Hay una etiqueta o cabecera que le pide a Google que no la indexe. Muy habitual tras una migración o en un WordPress con el ajuste de visibilidad activado. | Quitar la etiqueta si la página debe estar en el índice. Si es intencionada (gracias, carrito, área privada), no es un problema. |
| El archivo robots.txt ha bloqueado la URL | Una regla Disallow impide el rastreo. | Revisar el robots.txt. Cuidado con los bloqueos amplios heredados de un entorno de pruebas. |
| Rastreada: actualmente sin indexar | Google la ha visto y ha decidido no indexarla. Es una valoración del contenido. | Reescribir, ampliar o fusionar. Enlazarla desde páginas relevantes. No insistir con «Solicitar indexación». |
| Descubierta: actualmente sin indexar | Google conoce la URL pero aún no la ha rastreado. | Mejorar el enlazado interno y comprobar la velocidad y estabilidad del servidor. Suele resolverse con el tiempo. |
| Página alternativa con etiqueta canónica adecuada | La página apunta con rel=canonical a otra, y Google lo ha respetado. Normal en variantes de producto o versiones con parámetros. | Nada, si es lo que querías. Si querías indexarla, la canónica está mal puesta. |
| Duplicada: Google ha elegido una versión canónica diferente a la del usuario | Tú señalas una canónica y Google elige otra. Suele indicar que las dos páginas se parecen demasiado. | Diferenciar el contenido de verdad, o consolidar en una sola URL con redirección 301. |
| Duplicada: el usuario no ha indicado ninguna versión canónica | Hay varias URLs con el mismo contenido y ninguna declara cuál manda. | Declarar la canónica. Revisar parámetros, http/https y www/sin www. |
| Página con redirección | La URL redirige a otra. | Correcto por diseño. Solo revisar que el destino sea el que esperas y que no haya cadenas de tres o cuatro saltos. |
| Soft 404 | La página responde 200 pero parece vacía o sin contenido útil. Típico en resultados de búsqueda interna sin resultados o categorías sin productos. | Devolver un 404 o 410 real, o dar contenido de verdad a esa URL. |
| No se ha encontrado (404) | La URL no existe. | Si nunca existió, es normal. Si venía de una migración, redirigir a su equivalente. |
| Error del servidor (5xx) | El servidor falló cuando Google entró. | Es prioritario: los 5xx repetidos hacen que Google baje el ritmo de rastreo de todo el sitio. |
| Se ha indexado aunque un archivo robots.txt la tenía bloqueada | Aviso, no error. Google la ha indexado sin poder leerla, normalmente porque otros sitios la enlazan. | Si no quieres que aparezca, desbloquéala en robots.txt y usa noindex. Bloquear no es despublicar. |
«Descubierta: actualmente sin indexar»: una cola, no una avería
Es el estado que genera más falsos diagnósticos. La URL está en el sitemap, se ve bien en el navegador, no hay ningún noindex… y sigue fuera. La tentación es tocar cosas. En la mayoría de los casos, lo que hay es una cola.
Lo que sí puedes hacer para adelantar el turno:
- Enlázala desde donde Google ya pasa. Una página nueva colgada solo del sitemap y sin ningún enlace interno tiene poca prioridad. Un enlace desde la home, desde una categoría viva o desde un artículo que ya recibe visitas cambia mucho la señal.
- Revisa el rendimiento del servidor. Un hosting compartido que tarda dos segundos en responder invita a Google a rastrear menos. Si el informe de estadísticas de rastreo muestra tiempos de respuesta altos, ese es el trabajo.
- Limpia el ruido. Si tu sitemap tiene 12.000 URLs de las que 9.000 son filtros y paginaciones, estás repartiendo atención entre páginas que no te interesan.
Un caso concreto: una clínica dental de Madrid publica quince páginas de tratamiento el mismo día y las mete todas en el sitemap. Ninguna tiene enlace desde el menú ni desde la página de servicios. Tres semanas después, doce siguen en «Descubierta». No hay ningún error que corregir; hay un enlazado que no se hizo.
«Rastreada: actualmente sin indexar»: aquí el problema es el contenido
Este estado incomoda porque no ofrece nada que arreglar en el código. Google ha entrado, ha leído y ha pasado. Es su forma de decir que la página no aporta lo suficiente como para ocupar espacio en el índice.
Los patrones que se repiten:
- Contenido mínimo. Fichas de servicio de 120 palabras que no responden a nada.
- Plantillas replicadas por ciudad. «Fontanero en Getafe», «Fontanero en Leganés», «Fontanero en Alcorcón» con el mismo texto y el topónimo cambiado. Google agrupa o descarta.
- Contenido derivado. Un resumen de algo que ya está mejor explicado en otro sitio, sin dato propio, sin experiencia y sin criterio.
- Intención mal leída. La página existe, está bien escrita y responde a una pregunta que nadie hace de esa forma. Ahí el trabajo previo es de intención de búsqueda, no de indexación.
La salida es una de dos: reescribir con información que no esté en las tres primeras posiciones de google.es, o fusionar las páginas débiles en una sola sólida y redirigir el resto. Fusionar suele funcionar mejor de lo que parece: veinte páginas flojas indexadas a medias rinden menos que tres buenas.
El error que más veces hemos visto: noindex bloqueado por robots.txt
Alguien quiere sacar una sección del índice y hace las dos cosas a la vez: pone noindex en las páginas y las bloquea en el robots.txt. Parece más seguro. Es exactamente lo contrario.
La documentación de Google lo dice sin rodeos: si el rastreador no puede acceder a la página, no verá la regla noindex, y la página podría seguir apareciendo en los resultados de búsqueda. Para que noindex funcione, Google tiene que poder entrar a leerlo.
La regla práctica:
- Quieres que desaparezca del índice → permite el rastreo y usa
noindex. - Quieres ahorrar rastreo en zonas irrelevantes (búsquedas internas, filtros infinitos) → usa
robots.txt, y acepta que alguna URL pueda quedar indexada sin contenido si alguien la enlaza. - Quieres que desaparezca ya y es urgente (datos personales, una página publicada por error) → herramienta de retiradas de Search Console para el efecto inmediato, y detrás el arreglo permanente.
¿Sirve pedir la indexación a mano? ¿Y la Indexing API?
«Solicitar indexación» en la Inspección de URLs sirve para poner una URL nueva o actualizada en la cola antes. Google advierte de dos cosas: enviar la solicitud no garantiza que la página aparezca en el índice, y el número de solicitudes diarias está limitado. Para muchas páginas nuevas o modificadas, la propia ayuda de Google recomienda enviar un sitemap en lugar de ir de una en una.
Sobre la Indexing API, que sale mucho en foros y en herramientas que prometen indexación inmediata: su documentación limita su uso a páginas con datos estructurados JobPosting o con un BroadcastEvent incrustado en un VideoObject. Ofertas de empleo y emisiones en directo. No es una vía válida para un blog, una tienda o unas páginas de servicio, y conviene saberlo antes de pagar por un servicio que la use así.
Y el sitemap, mientras estamos: un archivo no puede superar 50 MB sin comprimir ni contener más de 50.000 URLs. Si te pasas, hay que partirlo y usar un índice de sitemaps.
¿Es un problema de presupuesto de rastreo?
Casi nunca, si tu sitio es normal. Google dirige su guía de presupuesto de rastreo a sitios grandes —más de un millón de páginas únicas con contenido que cambia cada semana— y a sitios medianos o grandes —más de 10.000 páginas únicas con cambios diarios—. Y añade una frase que ahorra muchas horas: si tu sitio no tiene muchas páginas que cambien rápido, o si tus páginas se rastrean el mismo día que se publican, no hace falta que leas esa guía.
Traducido: para la web de 60 páginas de un restaurante en Valencia, el presupuesto de rastreo no es el problema. Lo será el enlazado, el contenido o un noindex olvidado. En un e-commerce de Sevilla con 80.000 URLs generadas por filtros, sí toca mirarlo.
Si no está indexada, tampoco la va a citar la IA
Aquí es donde la indexación deja de ser un asunto técnico de segunda fila. La documentación de Google sobre funciones de IA es clara: para que una página aparezca como enlace de contribución en las Vistas creadas con IA o en el Modo IA, tiene que estar indexada y cumplir los requisitos técnicos de la Búsqueda. No hay requisitos adicionales ni un canal paralelo.
De modo que el orden correcto es este: primero indexada, después optimizada para ser citada. Trabajar la parte de AEO y GEO sobre páginas que están fuera del índice es construir sin cimientos.
Dos matices que conviene tener claros, porque se confunden a menudo:
- Los controles de fragmentos (
nosnippet,data-nosnippet,max-snippet) ynoindexlimitan lo que Google puede mostrar de tu página, incluidas las funciones de IA. Si los aplicas «por prudencia», estás recortando también tu visibilidad en IA. - Google-Extended es otra cosa: se gestiona en
robots.txty afecta al entrenamiento y a la fundamentación de los modelos de Google, no a que aparezcas en la Búsqueda. Bloquearlo no te saca de las Vistas creadas con IA, y desbloquearlo no te mete en ellas.
Si además quieres saber qué visibilidad estás teniendo ahí, eso se mide aparte: tráfico de IA en GA4 y Search Console.
Checklist: qué revisar cuando una página no se indexa
En este orden. Casi siempre se cae en los cinco primeros puntos.
- Inspecciona la URL en Search Console y anota el estado exacto y la canónica elegida por Google.
- Busca el
noindex: en el HTML (<meta name="robots" content="noindex">), en la cabecera HTTPX-Robots-Tagy en el ajuste de visibilidad del CMS. - Revisa el
robots.txtbuscando reglas heredadas del entorno de pruebas o bloqueos demasiado amplios. - Comprueba la canónica: que la página se apunte a sí misma, salvo que quieras lo contrario.
- Verifica el código de respuesta: 200 real, no un 200 con contenido vacío ni una redirección encadenada.
- Confirma que está en el sitemap y que el sitemap está enviado y sin errores.
- Cuenta los enlaces internos que apuntan a esa página. Si son cero, ese es el trabajo de esta semana.
- Comprueba si el contenido carga sin JavaScript. Si el texto principal solo aparece tras ejecutar scripts, mira la pestaña de HTML renderizado en la Inspección de URLs.
- Busca páginas casi idénticas en tu propio sitio. La competencia interna explica buena parte de los duplicados.
- Mira los errores 5xx y el tiempo de respuesta en Estadísticas de rastreo.
- Revisa los datos estructurados si la página aspira a un resultado enriquecido; no indexan por sí solos, pero ayudan a que Google entienda la entidad. Aquí, qué schema sirve de verdad.
- Solo entonces, si todo está limpio y la página es buena, solicita la indexación. Una vez.
Si sigues este orden con un cliente delante, la conversación cambia: dejas de decir «hay que esperar» y empiezas a decir «está fuera por esto y se arregla así». Es el mismo enfoque de la auditoría SEO básica en 15 puntos, aplicado a un solo síntoma.
Cuánto tarda y qué es razonable esperar
La ayuda de Search Console habla de en torno a un día tras solicitar la indexación, con la advertencia expresa de que en algunos casos puede tardar bastante más. En sitios pequeños y bien enlazados, de unos días a dos semanas es lo habitual.
Dos plazos que ayudan a gestionar expectativas:
- Menos de dos semanas: no hay diagnóstico. Es cola.
- Más de un mes con el informe limpio: el problema es de calidad o de duplicación, no técnico. Toca contenido.
Y una advertencia honesta: hay páginas que no se van a indexar nunca, y a veces está bien. Una ficha de producto agotado, una nota de prensa de 2019, la página 7 de un listado. Perseguir el 100% de indexación es perseguir un número que a nadie le paga la factura.
Lo que conviene recordar
La indexación no se arregla insistiendo, se arregla diagnosticando. Abre el informe, identifica el estado, y a partir de ahí ya sabes si tienes un problema de acceso (se resuelve en una tarde), de cola (se resuelve enlazando y esperando) o de contenido (se resuelve escribiendo mejor o fusionando).
Lo que casi nunca ayuda: volver a enviar el sitemap tres veces, pedir la indexación cada día de la misma URL, o añadir palabras clave a una página que Google ya ha leído y ha descartado. Eso último es el bucle en el que se pierden más semanas.
Y una última idea para las reuniones: en cuanto la IA entra en la conversación, la indexación deja de ser un detalle técnico y pasa a ser el requisito de entrada. Una página fuera del índice no aparece en Google, no se cita en las respuestas de IA y no existe para nadie salvo para quien tenga el enlace.
¿Tienes un cliente con páginas que no entran en el índice? Preparamos auditorías de SEO técnico y de visibilidad en IA en marca blanca: te las entregamos con tu marca, con el diagnóstico por URL y las acciones ordenadas por impacto, para que las revendas o las lleves a la próxima reunión. Están pensadas para agencias y freelances en España y son compatibles con proyectos de Kit Digital si trabajas como agente digitalizador. Mándanos un dominio y te preparamos una de muestra.
Preguntas frecuentes
¿Por qué Google no indexa mi web?
Casi siempre por una de cuatro razones: hay un bloqueo o un noindex, Google la ha rastreado y no la ha considerado lo bastante útil, la ha agrupado con otra casi idéntica y ha elegido esa otra como canónica, o todavía no le ha llegado el turno. El informe «Indexación de páginas» de Search Console te dice cuál de las cuatro es. Y conviene recordar que Google no garantiza indexar todas las páginas de un sitio.
¿Qué significa «Descubierta: actualmente sin indexar»?
Que Google conoce la URL pero aún no la ha rastreado. Está en cola. Se acelera con enlaces internos desde páginas que Google ya visita y con un servidor que responda rápido y sin errores 5xx.
¿Y «Rastreada: actualmente sin indexar»?
Que Google ha entrado, ha leído la página y ha decidido no indexarla. Es un juicio sobre el contenido: páginas cortas, plantillas replicadas por ciudades o temas ya mejor resueltos en otro sitio. Se arregla reescribiendo o fusionando, no volviendo a pedir indexación.
¿Sirve de algo pulsar «Solicitar indexación»?
Para una URL nueva o recién actualizada, sí: la pone antes en la cola. Google avisa de que no garantiza la indexación y de que las solicitudes diarias están limitadas. Repetirla sobre la misma URL no ayuda; para muchas páginas, la recomendación oficial es enviar un sitemap.
¿Puedo usar la Indexing API para indexar más rápido?
Solo para ofertas de empleo y emisiones en directo. La documentación de Google limita su uso a páginas con JobPosting o con un BroadcastEvent incrustado en un VideoObject. Para un blog o una tienda no es una vía válida, aunque haya servicios que la vendan como tal.
¿Es normal tener páginas sin indexar?
Sí, y en un sitio grande es lo esperable. Etiquetas, paginaciones, filtros, páginas de agradecimiento o fichas descatalogadas no tienen por qué estar en el índice. La pregunta correcta no es cuántas páginas están fuera, sino si están fuera las que te importan.
Fuentes
- Ayuda de Search Console — Informe de indexación de páginas: nombres exactos de los estados de no indexación («Rastreada: actualmente sin indexar», «Descubierta: actualmente sin indexar», «Página alternativa con etiqueta canónica adecuada», «Duplicada: Google ha elegido una versión canónica diferente a la del usuario», «Soft 404», «Error del servidor (5xx)») y de los avisos («Se ha indexado aunque un archivo robots.txt la tenía bloqueada», «La página se ha indexado sin contenido»).
- Google Search Central — Bloquear la indexación con noindex: si el rastreador no puede acceder a la página, no verá la regla
noindex, por lo que la página podría seguir apareciendo en los resultados de búsqueda. - Ayuda de Search Console — Herramienta de inspección de URLs: enviar una solicitud de indexación no garantiza que la página aparezca en el índice; el número de solicitudes diarias es limitado; para muchas páginas nuevas o actualizadas la mejor opción es enviar un sitemap; la indexación suele tardar en torno a un día y en algunos casos considerablemente más.
- Google Search Central — Crear y enviar un sitemap: un sitemap no puede superar 50 MB sin comprimir ni incluir más de 50.000 URLs; si se excede, hay que dividirlo o usar un índice de sitemaps.
- Google Search Central — Gestionar el presupuesto de rastreo en sitios grandes: la guía se dirige a sitios con más de un millón de páginas únicas y cambios semanales, o con más de 10.000 páginas únicas y cambios diarios; si las páginas se rastrean el mismo día que se publican, no hace falta leerla.
- Google Search Central — Funciones de IA en la Búsqueda de Google: para aparecer como enlace de contribución en las Vistas creadas con IA o en el Modo IA, la página debe estar indexada y cumplir los requisitos técnicos de la Búsqueda;
nosnippet,data-nosnippet,max-snippetynoindexlimitan lo que se muestra, incluidas las funciones de IA; Google-Extended se gestiona por separado enrobots.txt. - Google — Indexing API: guía de inicio rápido: la Indexing API solo puede usarse para rastrear páginas con
JobPostingo con unBroadcastEventincrustado en unVideoObject.
Nota sobre los ejemplos: los casos de la clínica dental de Madrid, el restaurante de Valencia y el e-commerce de Sevilla son ilustrativos y sirven para mostrar el tipo de diagnóstico. No son proyectos reales ni datos de mercado.